
Паспорт РФ
ФИО, дата рождения, серия и номер, орган выдачи и код подразделения.
Разработали API, который извлекает данные из документов и возвращает их для заполнения анкеты. Значения полей, предупреждения и проверки собраны в одном ответе.
Подключён к сервису анкет Zagran
Данные для анкетыв структурированном ответе


О проекте
Паспортные реквизиты, даты, данные ребёнка и адрес регистрации приходится вводить в формы вручную. На фотографии эти сведения уже есть, но у документов разная структура, шрифты и качество снимка.
Сделали отдельный сервис распознавания. Он принимает файл, выбирает конвейер документа и возвращает готовые поля с проверками. Анкета может подставить результат и оставить пользователю возможность сверить и исправить данные.
ФИО, дата рождения, серия и номер, орган выдачи и код подразделения.
Реквизиты, даты, орган выдачи и данные машиночитаемой зоны.
Данные ребёнка, родителей, серия, номер и актовая запись.
Дата регистрации, исходная строка адреса и его отдельные части.
Результат распознавания
Ответ API содержит значения, оценки уверенности и признаки проверки. Частичный результат помогает заполнить найденные поля и выделить то, что требует уточнения.
Примеры ниже показывают структуру ответа API. Все персональные данные и оценки уверенности вымышлены
Пример ответа
Вымышленный образец
Паспорт РФИллюстрация входящего файлаРазворот делится на зоны. Поля с разных страниц дополняют общий результат: личные данные, серия, номер и орган выдачи.
{
  "request_id": "demo-request",
  "status": "success",
  "document_type": "passport_rf_internal",
  "detected_document_type": "passport_rf_internal",
  "fields": {
    "last_name": {
      "value": "ИВАНОВ",
      "confidence": 0.98
    },
    "first_name": {
      "value": "ИВАН",
      "confidence": 0.97
    },
    "passport_series": {
      "value": "4500",
      "confidence": 0.96
    },
    "passport_number": {
      "value": "123456",
      "confidence": 0.96
    },
    "birth_date": {
      "value": "1990-01-15",
      "confidence": 0.95
    },
    "division_code": {
      "value": "770-001",
      "confidence": 0.89
    }
  },
  "validation": {
    "format_checks_passed": true,
    "mrz_match": null,
    "required_fields_present": true
  },
  "warnings": []
}
Пример ответа
Вымышленный образец
ЗагранпаспортИллюстрация входящего файлаВымышленный пример частичного ответа. Серия, номер и даты распознаны, поле органа выдачи нужно заполнить вручную. Машиночитаемая зона помогает сверять реквизиты.
{
  "request_id": "demo-request",
  "status": "partial",
  "document_type": "passport_rf_international",
  "detected_document_type": "passport_rf_international",
  "fields": {
    "passport_series": {
      "value": "75",
      "confidence": 0.99
    },
    "passport_number": {
      "value": "1234567",
      "confidence": 0.99
    },
    "issue_date": {
      "value": "2024-02-10",
      "confidence": 0.96
    },
    "expiration_date": {
      "value": "2034-02-10",
      "confidence": 0.99
    },
    "first_name": {
      "value": "IVAN",
      "confidence": 0.98
    }
  },
  "validation": {
    "format_checks_passed": true,
    "mrz_match": true,
    "required_fields_present": false
  },
  "warnings": [
    "issued_by not detected"
  ]
}
Пример ответа
Вымышленный образец
СвидетельствоИллюстрация входящего файлаОтдельный конвейер учитывает формы свидетельств, подписи полей и похожие латинские и кириллические символы. Возвращаются данные ребёнка, родителей и актовой записи.
{
  "request_id": "demo-request",
  "status": "success",
  "document_type": "birth_certificate",
  "detected_document_type": "birth_certificate",
  "fields": {
    "child_name": {
      "value": "ИВАНОВА АННА ИВАНОВНА",
      "confidence": 0.96
    },
    "birth_date": {
      "value": "2018-05-20",
      "confidence": 0.95
    },
    "series": {
      "value": "I-МЮ",
      "confidence": 0.94
    },
    "number": {
      "value": "123456",
      "confidence": 0.97
    },
    "act_number": {
      "value": "1234",
      "confidence": 0.93
    },
    "mother_name": {
      "value": "ИВАНОВА МАРИЯ ПЕТРОВНА",
      "confidence": 0.92
    }
  },
  "validation": {
    "format_checks_passed": true,
    "mrz_match": null,
    "required_fields_present": true
  },
  "warnings": []
}
Пример ответа
Вымышленный образец
РегистрацияИллюстрация входящего файлаСервис выделяет дату и части адреса: регион, город, улицу, дом. Исходная строка адреса сохраняется в ответе и помогает сверить результат распознавания штампа.
{
  "request_id": "demo-request",
  "status": "success",
  "document_type": "passport_rf_registration",
  "detected_document_type": "passport_rf_registration",
  "fields": {
    "registration_date": {
      "value": "2020-06-15",
      "confidence": 0.92
    },
    "region": {
      "value": "МОСКВА",
      "confidence": 0.86
    },
    "city": {
      "value": "МОСКВА",
      "confidence": 0.88
    },
    "street": {
      "value": "ПРИМЕРНАЯ",
      "confidence": 0.82
    },
    "house": {
      "value": "1",
      "confidence": 0.82
    },
    "address_raw": {
      "value": "Г. МОСКВА УЛ. ПРИМЕРНАЯ Д. 1",
      "confidence": 0.92
    }
  },
  "validation": {
    "format_checks_passed": true,
    "mrz_match": null,
    "required_fields_present": true
  },
  "warnings": []
}
Оценки уверенности относятся к отдельным распознанным полям и помогают выбрать данные для дополнительной проверки. В этом примере они заданы вручную для демонстрации.
Как работает
Основной конвейер выполняется на сервере сервиса. Для обработки документа используются локальные OCR-движки, отдельные правила извлечения и проверки полей.
Фото или первая страница PDF
Границы, наклон и контраст
RapidOCR и Tesseract
Конвейер выбранного документа
Форматы, полнота и MRZ
Интеграция
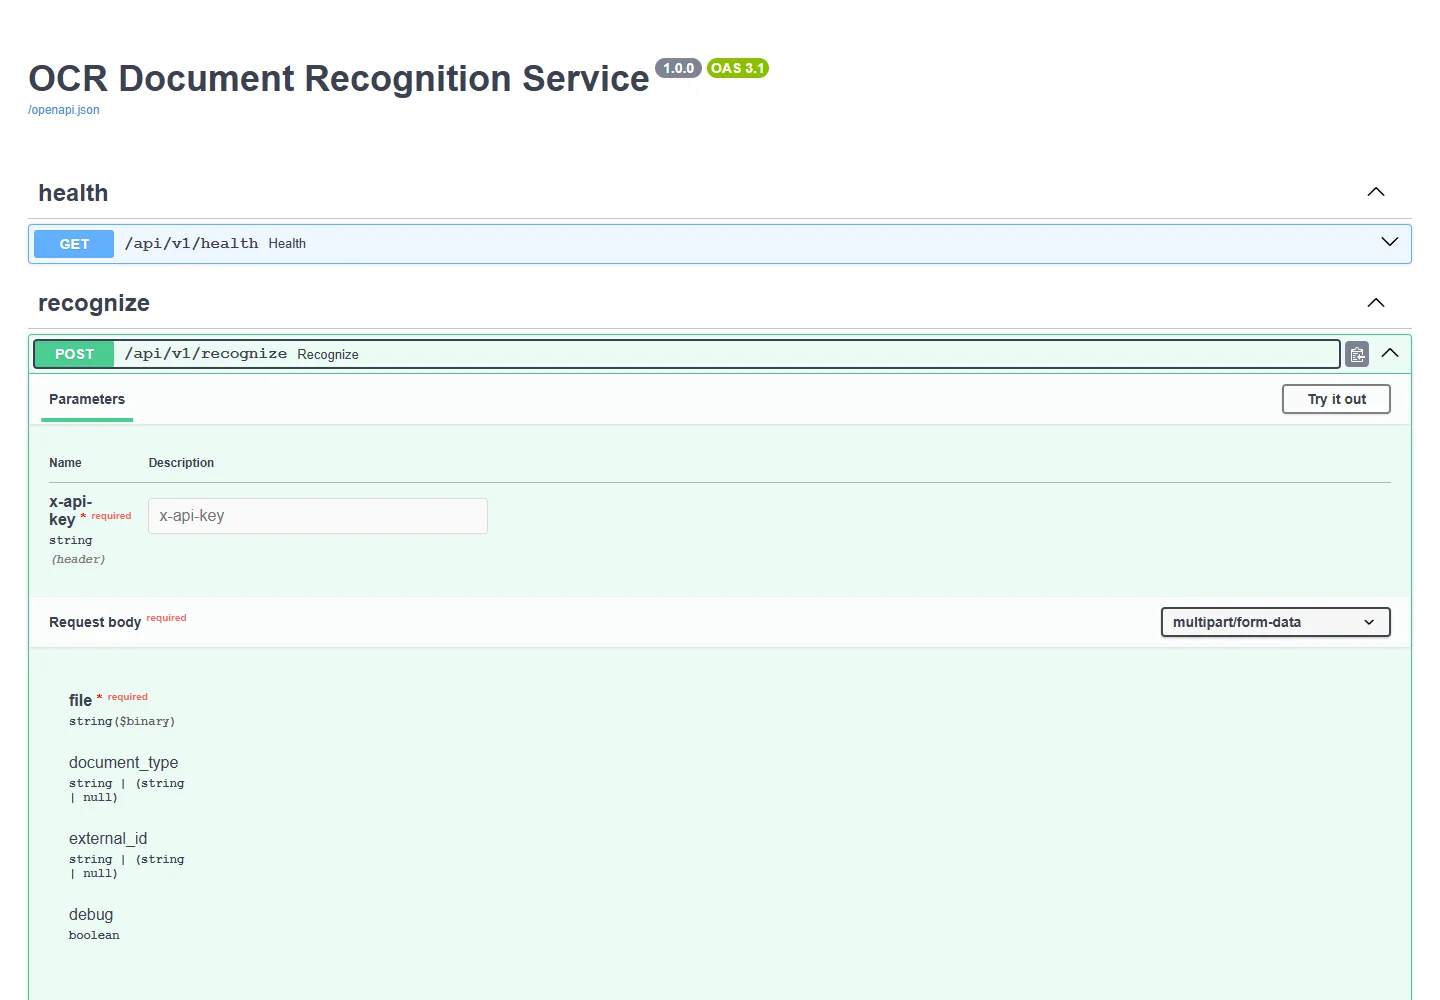
API принимает файл и необязательную подсказку типа документа. Схема ответа единая для всех конвейеров. Этот сервис подключён к Zagran, где данные документов используются при заполнении анкеты.
Разработка
Сложности были в качестве снимков, разных формах документов, чтении штампов и ограничениях сервера. Для этих случаев сделали отдельные проходы и правила обработки.
Перед OCR определяем границы документа, исправляем перспективу и небольшой наклон, усиливаем контраст. Разворот паспорта разбираем по страницам: зоны личных данных и реквизитов получают отдельные проходы. Для штампа регистрации предусмотрена своя подготовка изображения.
Сделали четыре конвейера извлечения. Объединяем строки RapidOCR и Tesseract, учитываем расположение полей и похожие латинские и кириллические символы. В паспортах используем машиночитаемую зону: проверяем контрольные цифры и сопоставляем её с видимыми реквизитами.
Исходный OCR-движок не запускался на процессоре сервера без AVX. Перешли на RapidOCR с ONNX Runtime, сохранив общий интерфейс распознавания. Независимые проходы OCR и обработку страниц паспорта запускаем параллельно. Для загранпаспорта Tesseract используется как дополнительный проход, когда первого результата недостаточно.
API возвращает значения полей, оценки уверенности, проверки форматов и обязательных данных, предупреждения и статус частичного результата. Тип, определённый классификатором, отдаётся отдельно от подсказки клиента. Доступ к распознаванию защищён X-API-Key, для файлов есть ограничение размера и обработка неподдерживаемых форматов.
Результат
Сервис возвращает данные документов в общей структуре и уже используется в анкетах Zagran. Качество ответа можно проверять по полям, полноте результата и предупреждениям.
Включая страницу регистрации в паспорте
JPEG, PNG, WebP и первая страница PDF
RapidOCR и Tesseract в одном конвейере
Один и тот же набор для v2 и v3
Сравнение v2 и v3
Сравнение выполнено на одном наборе из 11 сканов четырёх типов документов. Сохранённые результаты прогона от . Это замер конкретного тестового набора; время отдельного запроса зависит от изображения и типа документа.
Число конвейеров, форматы файлов и движки проверены по исходному коду проекта на . Публичные документация и health-эндпоинт доступны. Сохранённые замеры скорости относятся к сравнению версий, а примеры выше показывают вымышленный ответ API.
Распознавание встроено в общий путь заполнения анкеты. Сервис отдаёт найденные поля и сигналы проверки, а пользователь может сверить результат с документом и исправить его в форме.
Следующий продукт
Разберём типы файлов, поля, проверки и интеграцию с вашей системой
